跳到正文
Physical Harness 框架总图

RISE
策略自进化

融合真实经验与想象轨迹更新策略
通过验证的策略返回实机执行

RISE 论文
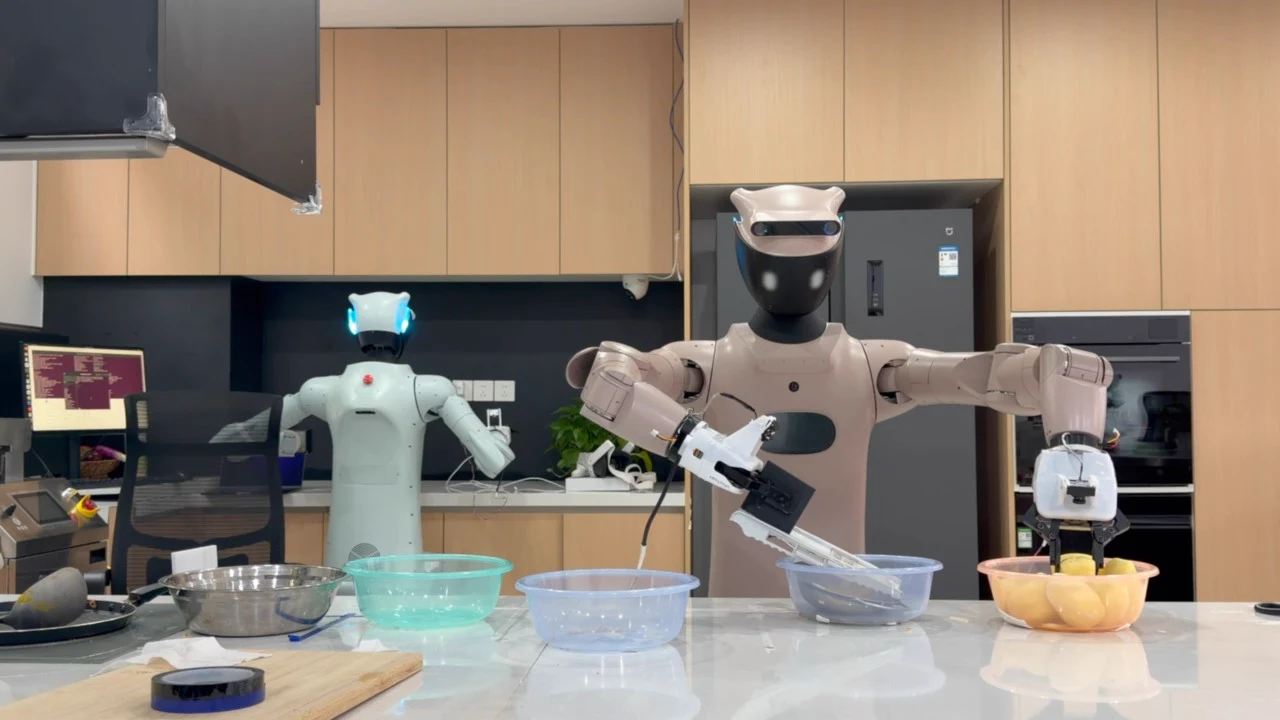
机器人在厨房中进行土豆备料

实机作业

任务执行伪代码
goal = "Prepare shredded potatoes"
policy = load_validated_policy()

while not terminal(state):
    observation = robot.observe()
    action = policy(observation, goal)
    result = robot.execute(action)
    episode.record(observation, result)
    state = check_progress(result)

experience.save(episode)

想象与策略学习

  1. oₜ

    当前观测

    作为策略与世界模型的共同输入

  2. πₖ

    Policy

    根据观测生成下一段动作

  3. aₜ

    动作序列

    与当前观测一起输入 Dynamics

  4. oₜ + aₜ

    Dynamics

    预测执行动作后的观测

  5. ôₜ₊₁

    未来观测

    接续后面的想象

  6. V(ôₜ₊₁)

    Value Model

    评估预测的任务进度

  7. πₖ → πₖ₊₁

    Policy Learning

    由价值变化构造优势条件并更新策略

  8. 更新后的策略进入下一轮想象

同一起点
不同未来

从相同的 4 帧真实观测出发
同一 Dynamics 模型根据不同的数据集动作预测 6 秒未来
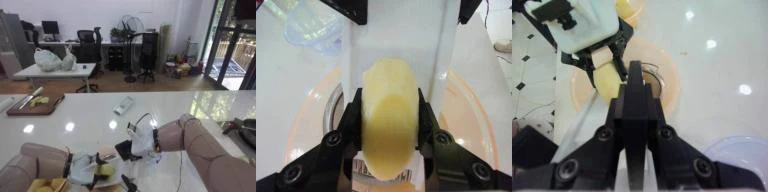
两条未来共享的头部与双腕初始观测

策略迭代对比

三阶段策略从相同观测独立预测 5 秒未来
使用同一价值模型与同一刻度评价任务进度
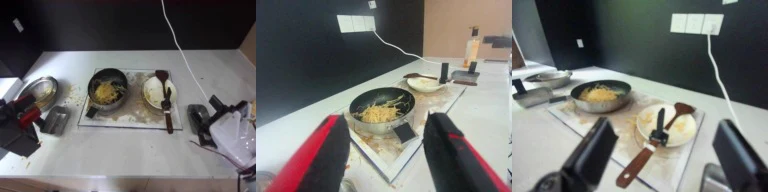
从碗边移向炒锅

Episode
423
初始观测帧
626 至 629
三阶段策略共享的初始观测

价值评价与策略学习

SFT 逐帧预测 Value所选片段 0.00 至 1.67 s 起点 0.4890 均值 0.4980
片段起点 Value
0.4890
预测均值 Value
0.4980
平均价值变化 ΔV
+0.0090
  1. 优势条件

    将片段平均 Value 减去起点 Value 再经缩放与截断形成优势条件

  2. Policy Learning

    结合当前观测 策略动作与优势条件更新策略参数

  3. 下一轮 Policy

    更新后的策略重新提出动作 继续想象与评价

接近路径与工具朝向

Episode
393
初始观测帧
856 至 859
三阶段策略共享的初始观测

价值评价与策略学习

SFT 逐帧预测 Value所选片段 0.00 至 1.67 s 起点 0.4811 均值 0.4768
片段起点 Value
0.4811
预测均值 Value
0.4768
平均价值变化 ΔV
-0.0042
  1. 优势条件

    将片段平均 Value 减去起点 Value 再经缩放与截断形成优势条件

  2. Policy Learning

    结合当前观测 策略动作与优势条件更新策略参数

  3. 下一轮 Policy

    更新后的策略重新提出动作 继续想象与评价

从接近到进入锅内

Episode
545
初始观测帧
614 至 617
三阶段策略共享的初始观测

价值评价与策略学习

SFT 逐帧预测 Value所选片段 0.00 至 1.67 s 起点 0.4232 均值 0.4422
片段起点 Value
0.4232
预测均值 Value
0.4422
平均价值变化 ΔV
+0.0189
  1. 优势条件

    将片段平均 Value 减去起点 Value 再经缩放与截断形成优势条件

  2. Policy Learning

    结合当前观测 策略动作与优势条件更新策略参数

  3. 下一轮 Policy

    更新后的策略重新提出动作 继续想象与评价

预测方法

三阶段共享 4 帧真实观测 每轮策略输出动作后 Dynamics 预测 25 帧 再以前一轮末尾 4 帧接续 共生成 75 帧 视频按原始 15 Hz 播放

模型预测的任务进度

Value 是已保存策略离线预测中的任务进度估计 并非实机成功率 连续预测会累积模型误差 策略差异结合动作与评分共同观察

RSI 闭环方案

  1. Task Agent

    设定子目标与约束 选择执行技能 响应任务反馈

  2. Policy 与技能

    根据观测和目标提出动作

  3. 机器人与环境

    将策略动作转为物理交互 接收执行与控制反馈

  4. 反馈与经验

    记录作业轨迹 结果与人工干预 用于候选更新和复测

作业轨迹与结果进入改进流程

评估通过的版本用于后续任务

  1. 经验采集

    记录观测与动作 关联任务结果和人工干预 保留产生轨迹的策略版本

    目标产物
    可追溯的作业记录
  2. 问题诊断

    比较目标与执行结果 定位偏差所在环节 提出具体的改进假设

    目标产物
    可验证的改进提案
  3. 候选更新

    构建技能或策略更新 RISE 分支结合真实与想象经验更新策略参数

    目标产物
    带版本的候选方案
  4. 受控实验

    固定任务条件与资源预算 将开发任务和评估条件分开 记录可比的复测结果

    目标产物
    同条件复测记录
  5. 效果评估

    与上一版本比较任务结果 检查泛化与性能退化 计入人工干预和成本

    目标产物
    采纳或拒绝的判断
  6. 版本保留

    保留验证通过的更新及其来源 支持回退 后续任务继续产生新经验

    目标产物
    可复用的验证版本

可改进对象

  • 记忆
  • 技能与工具
  • Harness
  • 训练数据
  • 策略参数
  • 改进流程

土豆制作的
自进化流程设计

  1. 经验采集

    记录削丝动作与食材变化

    原片 00:28.73
  2. 问题诊断

    检查接触位置与往复行程

    原片 01:03.84
  3. 候选更新

    生成削丝与翻炒的候选策略

    原片 00:28.73
  4. 受控实验

    在相同食材与起始条件下复测基线和候选策略

    原片 01:11.20
  5. 效果评估

    比较翻动覆盖与物料残留

    原片 01:52.14
  6. 版本保留

    保留有效策略用于后续土豆制作任务

    原片 02:10.87

RISE
自进化引擎

由 Policy Dynamics 和 Value 组成世界模型与策略学习系统 策略初始化于 π₀.₅ 自进化期间更新策略参数

论文与方法
  1. Policy

    提出动作

  2. Dynamics

    冻结参数

  3. Value

    冻结参数

优势条件策略学习

真实示范与想象轨迹共同更新策略 π′

动力学与价值模型在策略改进期间冻结 世界模型用于训练 实机推理由更新后的策略根据观测与目标执行

厨房任务记录

研发方向

进化
单项技能 → 流程协同 → 自进化
泛化
新任务 新场景 新本体