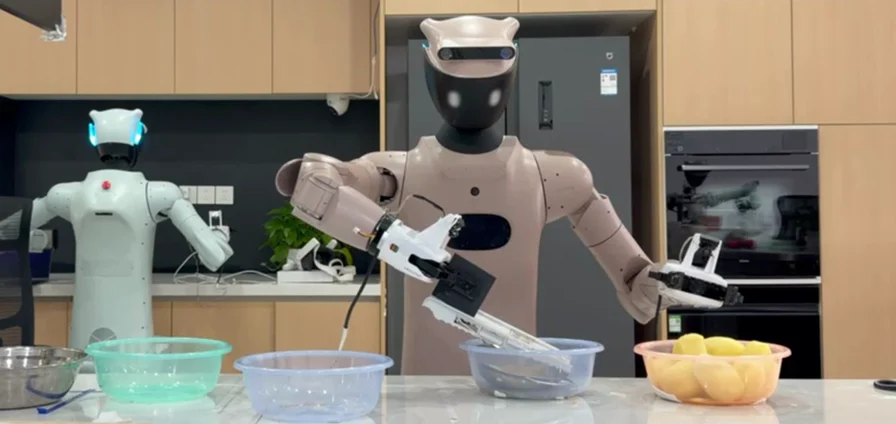
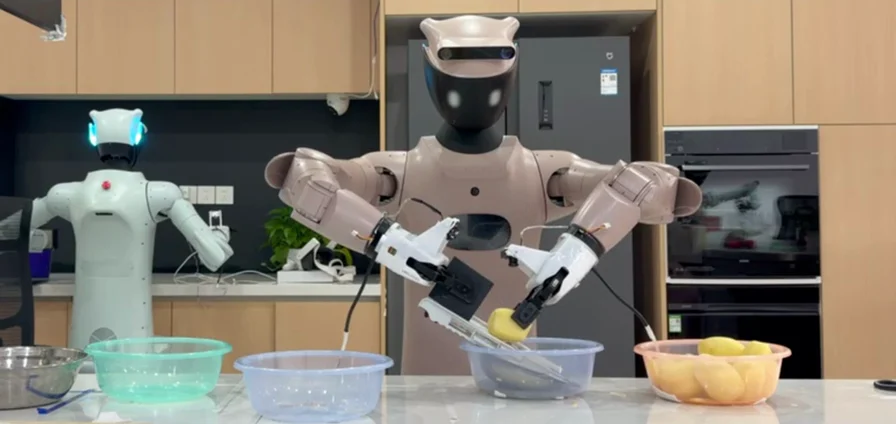
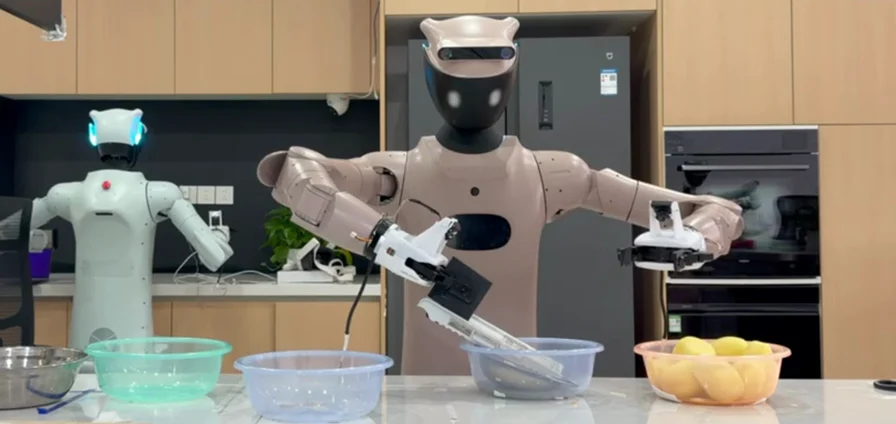
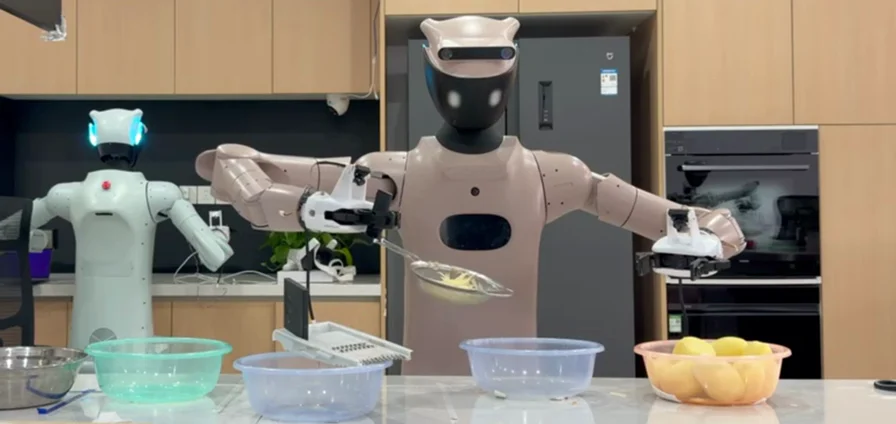
鸡蛋饼制作
阶段平均成功率
- π0.5
- 37.5%
- OpenWAM
- 40.0%
- Vela
- 67.5%
| 任务阶段 | π0.5 | OpenWAM | Vela |
|---|---|---|---|
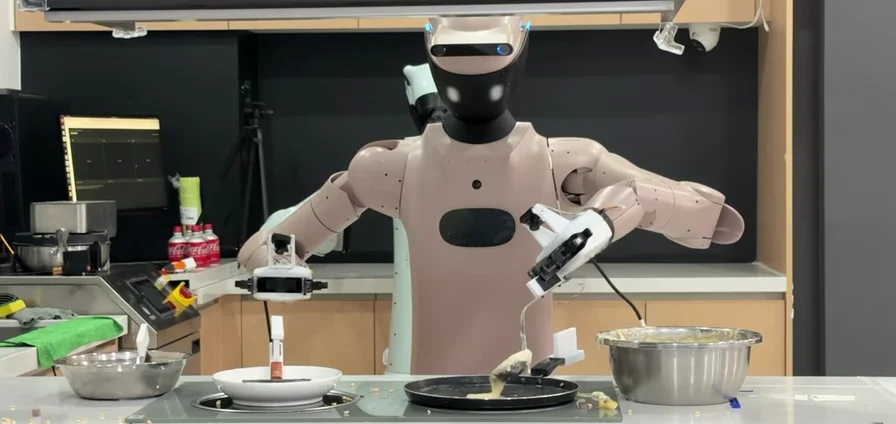 倒入面糊 | 80% | 90% | 100% |
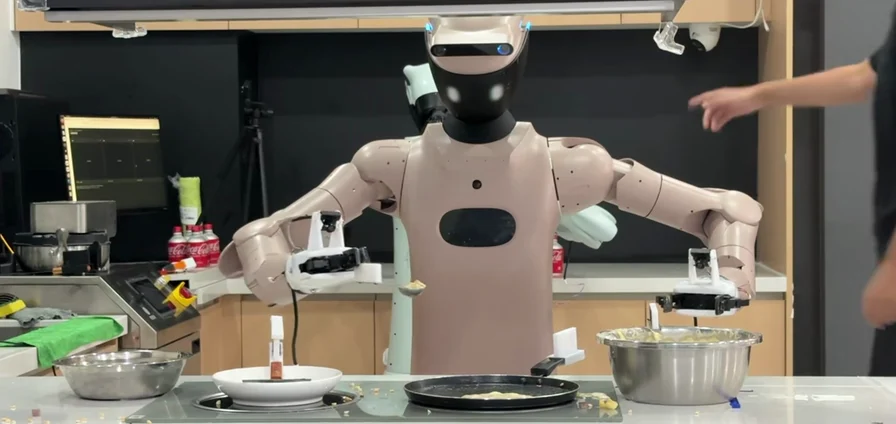 加入配料 | 20% | 30% | 80% |
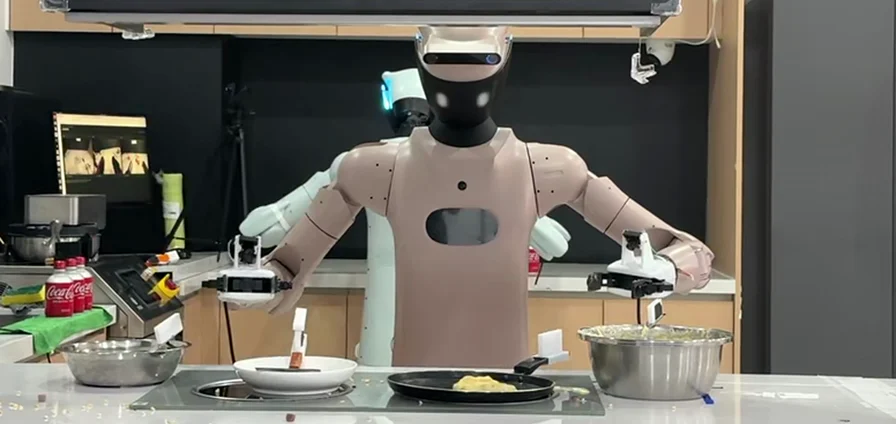 抓握平底锅 | 40% | 40% | 60% |
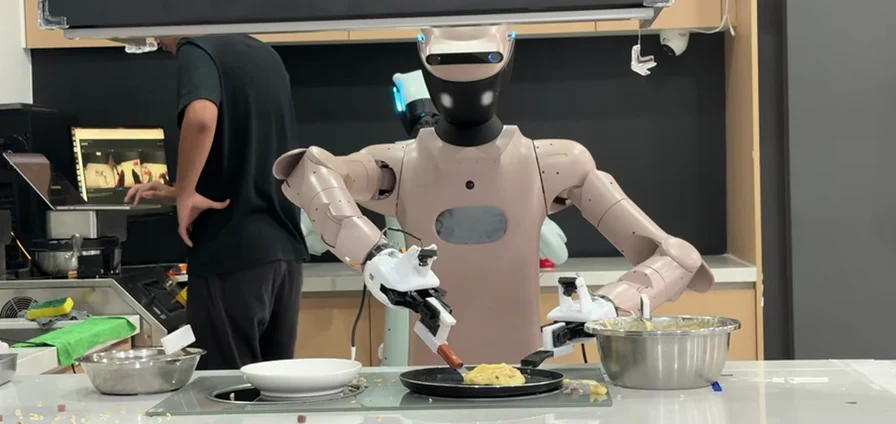 取饼装盘 | 10% | 0% | 30% |
通过样条控制点表示连续动作轨迹 联合预测动作的形状与覆盖时间
L1 至 L5 的变化逐级叠加
| 变化 | π0.5 | Vela | 提升 百分点 |
|---|---|---|---|
| L1局部空间扰动 | 65.2% | 67.2% | +2.0 |
| L2更大范围空间变化 | 53.2% | 55.9% | +2.7 |
| L3新的场景拓扑 | 36.0% | 44.9% | +8.9 |
| L4视觉属性与未见物体 | 24.1% | 31.5% | +7.4 |
| L5指令改写 | 18.0% | 27.1% | +9.1 |
轮式双臂机器人配备 7 自由度机械臂 头部与腕部相机 每个任务阶段试验 10 次 统计各阶段成功率及其平均值
H 个离散动作
相同输出预算覆盖更长时间时 采样变稀疏 快速修正可能被遗漏 相邻动作输出存在冗余 平滑性需要模型隐式学习
控制点 C 与时域 H
局部 B 样条基函数加权形成平滑曲线 每个控制点只影响附近轨迹 几何形状与覆盖时间分别表示 再按控制频率采样
16 至 40 步
沿用 π0.5 架构 不增加可训练参数 预训练使用约 4 万小时机器人数据
图像 指令 关节状态
3B
视觉语言主干编码上下文
300M
Flow matching 从噪声生成控制点与时域预测
矩阵乘法
相同数量的控制点在平滑移动中可以覆盖更长轨迹 在插入或对齐等精细操作中需要缩短覆盖范围 每个训练样本选择满足拟合条件的最长时域
通过最小二乘拟合样条 将残差按示范噪声方差和自由度归一化 能表示的轨迹得分接近 1 超出阈值时缩短时域 避免把示范噪声当作动作细节
夹爪开合具有突变且噪声方差可能接近零 单独使用均方根残差约束 阈值为 0.05
预先计算各时域的基函数矩阵与伪逆 训练时批量选择可接受的最大时域 无需额外标注或节点优化 部署时由策略联合预测控制点与时域